
Robots.txt là một file rất nhỏ, nhưng nếu cấu hình sai, hậu quả SEO có thể rất lớn.
Một dòng Disallow: / đặt sai chỗ có thể khiến Googlebot không crawl được toàn bộ website. Một rule chặn nhầm thư mục blog có thể làm bài mới mãi không được Google thu thập. Một cấu hình chặn CSS, JS có thể khiến Google khó render trang đúng cách. Một file robots.txt lỗi sau migration có thể làm technical SEO rối lên dù nội dung không có vấn đề.
Nhưng ở chiều ngược lại, robots.txt không phải “cây đũa thần” để xử lý mọi vấn đề index.
Robots.txt chủ yếu dùng để quản lý việc bot có được crawl một khu vực hoặc URL nào đó trên website hay không. Nó không phải công cụ chặn index tuyệt đối, không thay thế noindex, không thay thế canonical, không thay thế sitemap và cũng không nên dùng để che nội dung nhạy cảm.
Nói đơn giản: robots.txt là tấm biển chỉ đường cho bot. Nó nói bot nên hoặc không nên vào khu vực nào. Nhưng nó không quyết định cuối cùng một URL có được index hay không trong mọi trường hợp.
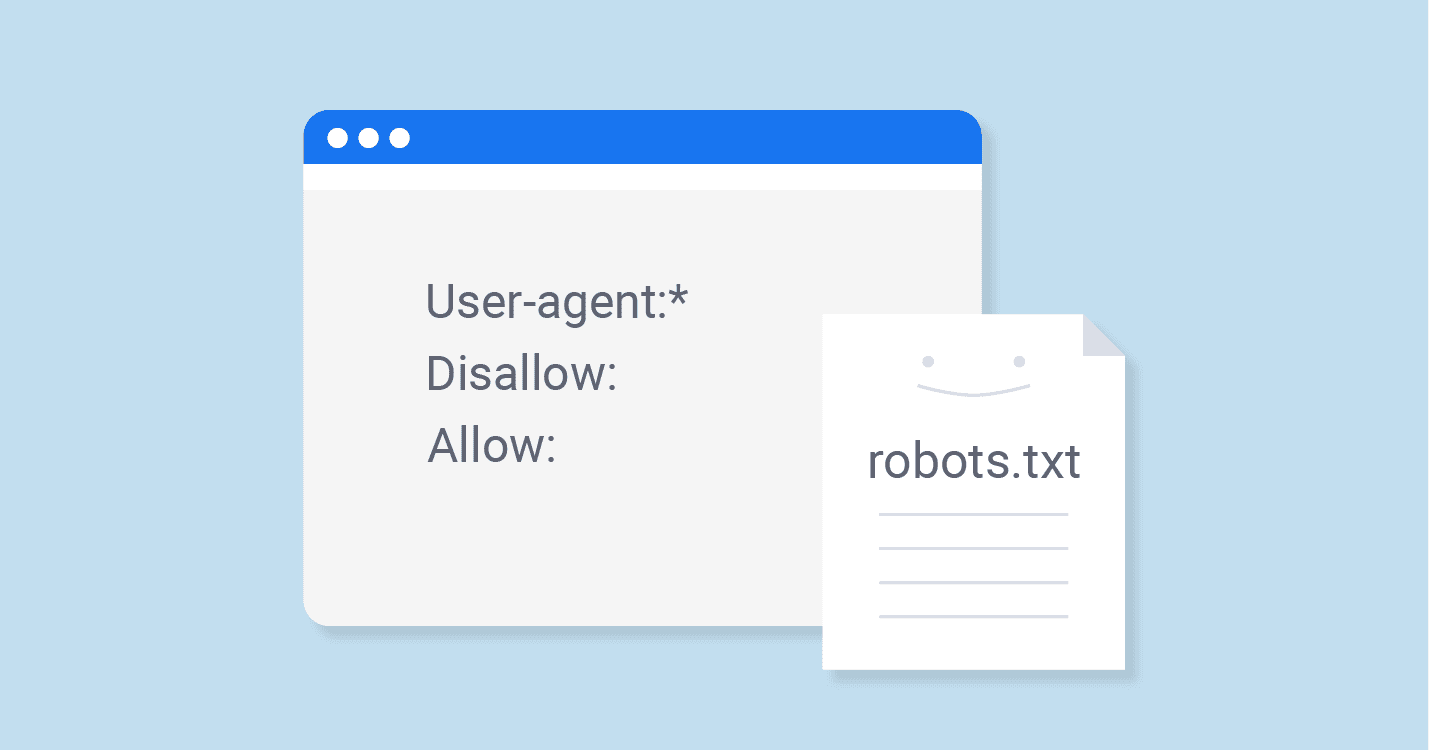
Robots.txt là gì?
Robots.txt là một file văn bản nằm ở thư mục gốc của website, dùng để hướng dẫn các crawler như Googlebot biết khu vực nào trên website được phép hoặc không được phép crawl.
Ví dụ file robots.txt của một website thường nằm ở:
https://example.com/robots.txtVới maikimtuyen.com, anh có thể kiểm tra tại:
https://maikimtuyen.com/robots.txtMột file robots.txt cơ bản có thể như sau:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Ý nghĩa đơn giản:
User-agent: *áp dụng cho tất cả bot.Disallow: /wp-admin/yêu cầu bot không crawl thư mục/wp-admin/.Allow: /wp-admin/admin-ajax.phpcho phép crawl file ajax cần thiết.Sitemap:khai báo vị trí sitemap.
Robots.txt là một phần của technical SEO, nhưng nó không khó nếu hiểu đúng bản chất: đây là file quản lý crawl, không phải file quản lý toàn bộ index.
Robots.txt dùng để làm gì?
Robots.txt dùng để kiểm soát bot có được crawl một số khu vực nhất định trên website hay không.
Trong SEO, robots.txt thường được dùng để:
- Chặn bot crawl khu vực quản trị không cần thiết.
- Hạn chế crawl các trang search nội bộ.
- Hạn chế crawl một số URL parameter hoặc filter không cần thiết.
- Khai báo sitemap cho bot.
- Giúp bot không mất thời gian vào khu vực không có giá trị SEO.
- Hỗ trợ quản trị crawl budget trên website lớn.
- Tránh bot truy cập các khu vực gây tải server không cần thiết.
Ví dụ với WordPress, một cấu hình thường gặp là:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Cấu hình này không chặn nội dung cần SEO như bài viết, trang, chuyên mục. Nó chỉ chặn khu vực quản trị không cần bot crawl.
Robots.txt không dùng để làm gì?
Đây là phần quan trọng hơn cả.
Robots.txt không nên được hiểu là công cụ xử lý mọi vấn đề SEO kỹ thuật.
Robots.txt không nên dùng để:
- Chặn index một trang HTML quan trọng.
- Ẩn nội dung nhạy cảm hoặc dữ liệu riêng tư.
- Xử lý duplicate content thay cho canonical.
- Xử lý bài cũ thay cho redirect 301.
- Che thin content thay cho content pruning.
- Chặn toàn bộ CSS, JS, ảnh cần thiết để Google render trang.
- Chặn nhầm thư mục bài viết, sản phẩm hoặc trang dịch vụ.
Nếu muốn một trang không xuất hiện trên Google Search, hướng đúng thường là noindex, không phải robots.txt.
Nếu muốn hợp nhất URL trùng hoặc gần trùng, hướng đúng thường là canonical.
Nếu URL cũ đã có URL mới thay thế liên quan, hướng đúng thường là 301 Redirect.
Robots.txt chỉ nên dùng khi mục tiêu là quản lý crawl.
Robots.txt nằm ở đâu?
File robots.txt phải nằm ở thư mục gốc của host mà nó áp dụng.
Ví dụ đúng:
https://example.com/robots.txtVí dụ sai:
https://example.com/blog/robots.txt
https://example.com/pages/robots.txt
Robots.txt cũng áp dụng theo protocol, host và port cụ thể.
Ví dụ:
https://example.com/robots.txtáp dụng chohttps://example.com/.- Nó không tự áp dụng cho
https://www.example.com/nếu đó là host khác. - Nó không tự áp dụng cho
http://example.com/nếu protocol khác. - Nó không tự áp dụng cho subdomain như
https://blog.example.com/.
Với website có nhiều subdomain, cần kiểm tra robots.txt riêng cho từng subdomain nếu các subdomain đó cần được Google crawl.
Cấu trúc cơ bản của robots.txt
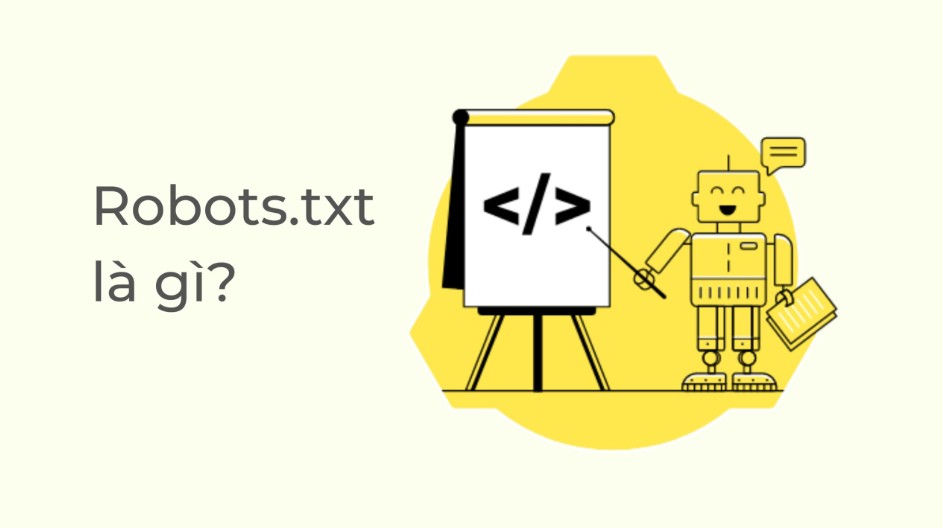
Một file robots.txt thường gồm các nhóm rule.
Cấu trúc cơ bản:
User-agent: [tên bot]
Disallow: [đường dẫn không cho crawl]
Allow: [đường dẫn cho phép crawl]

Sitemap: [đường dẫn sitemap]
User-agent
User-agent dùng để chỉ định bot nào áp dụng rule bên dưới.
Ví dụ áp dụng cho tất cả bot:
User-agent: *Ví dụ áp dụng riêng cho Googlebot:
User-agent: GooglebotTrong đa số trường hợp website thông thường, dùng User-agent: * là đủ.
Disallow
Disallow dùng để yêu cầu bot không crawl một đường dẫn.
Ví dụ:
Disallow: /wp-admin/Câu này yêu cầu bot không crawl thư mục /wp-admin/.
Chặn toàn bộ website:
User-agent: *
Disallow: /
Đây là cấu hình cực kỳ nguy hiểm nếu đang đặt trên website live.
Allow
Allow dùng để cho phép crawl một đường dẫn cụ thể, thường dùng khi thư mục mẹ bị chặn nhưng một file con vẫn cần crawl.
Ví dụ WordPress:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Ý nghĩa là chặn thư mục /wp-admin/, nhưng vẫn cho phép bot truy cập file admin-ajax.php.
Sitemap
Dòng Sitemap dùng để khai báo vị trí sitemap.
Sitemap: https://example.com/sitemap_index.xmlDòng sitemap có thể đặt ở bất kỳ đâu trong file robots.txt, miễn là đường dẫn chính xác.
Tuy nhiên, khai báo sitemap trong robots.txt không thay thế việc gửi sitemap trong Google Search Console. Tốt nhất nên làm cả hai.
Ví dụ robots.txt chuẩn cho WordPress
Với một website WordPress cơ bản, cấu hình có thể như sau:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Cấu hình này đơn giản và khá an toàn cho đa số website WordPress.
Không nên chặn các thư mục như:
Disallow: /wp-content/
Disallow: /wp-includes/
Disallow: /blog/
Disallow: /category/
Disallow: /tag/
một cách máy móc, vì trong đó có thể chứa tài nguyên hoặc URL mà Google cần để hiểu website.
Đặc biệt, không nên chặn CSS và JS quan trọng nếu Google cần chúng để render trang.
Robots.txt có chặn index không?
Không chắc chắn.
Đây là hiểu lầm phổ biến nhất.
Robots.txt chặn crawl, không phải chặn index tuyệt đối.
Nếu một URL bị robots.txt chặn, Googlebot không crawl được nội dung trang. Nhưng nếu Google biết URL đó qua liên kết ngoài, sitemap cũ hoặc nguồn khác, URL vẫn có thể xuất hiện trên Google trong một số trường hợp, thường không có mô tả nội dung đầy đủ.
Muốn chặn một trang không xuất hiện trên Google Search, dùng noindex mới là hướng phù hợp hơn.
Nhưng để Google thấy được noindex, Googlebot cần crawl được trang đó.
Vì vậy, lỗi thường gặp là:
Disallow: /tag/Trong các trang tag lại có:
<meta name="robots" content="noindex">Nếu Googlebot bị chặn bởi robots.txt, nó có thể không thấy được thẻ noindex.
Cách hiểu đúng:
- Muốn chặn crawl: dùng robots.txt.
- Muốn chặn index: dùng noindex và cho phép Google crawl trang để thấy noindex.
Anh em có thể đọc thêm bài Noindex là gì để phân biệt kỹ hơn giữa chặn crawl và chặn index.
Robots.txt khác gì noindex?
| Tiêu chí | Robots.txt | Noindex |
|---|---|---|
| Mục tiêu | Quản lý crawl | Chặn trang xuất hiện trên Search |
| Bot có được vào trang không? | Không, nếu bị Disallow | Có, để đọc được noindex |
| Dùng khi | Không muốn bot crawl một khu vực | Trang cần tồn tại nhưng không cần Search |
| Ví dụ | Chặn khu vực search nội bộ hoặc parameter lớn | Thank you page, tag mỏng, trang tài khoản |
Nếu một trang cần tồn tại cho người dùng nhưng không cần xuất hiện trên Google, noindex thường đúng hơn robots.txt.
Nếu một khu vực rất lớn không cần bot crawl và có thể gây lãng phí crawl, robots.txt có thể được cân nhắc sau khi phân loại kỹ.
Robots.txt khác gì canonical?
Canonical dùng để gợi ý URL đại diện trong nhóm URL trùng hoặc gần trùng.
Robots.txt dùng để chặn hoặc cho phép crawl.
Không nên dùng robots.txt để xử lý canonicalization.
Ví dụ có URL:
/giay-nam//giay-nam/?sort=price_asc
Nếu URL sort chỉ thay đổi thứ tự hiển thị, canonical về URL chính có thể phù hợp hơn chặn robots.txt.
Nếu chặn URL sort bằng robots.txt, Googlebot có thể không crawl được URL đó để thấy canonical.
Vì vậy, với duplicate content, URL parameter và filter, cần phân loại cẩn thận:
- URL gần giống, vẫn cần truy cập: cân nhắc canonical.
- Trang cần tồn tại nhưng không cần Search: cân nhắc noindex.
- Khu vực không cần crawl ở quy mô lớn: cân nhắc robots.txt.
- URL cũ không cần tồn tại: cân nhắc 301 Redirect.
Anh em có thể đọc thêm bài Canonical URL là gì để tránh dùng robots.txt sai mục tiêu.
Robots.txt khác gì sitemap?
Sitemap và robots.txt thường được đặt cạnh nhau, nhưng mục tiêu trái ngược nhau.
Sitemap nói với bot: “Đây là những URL quan trọng tôi muốn anh chú ý”.
Robots.txt nói với bot: “Khu vực này được hoặc không được crawl”.
| Tiêu chí | Sitemap | Robots.txt |
|---|---|---|
| Mục tiêu | Giới thiệu URL quan trọng | Quản lý crawl |
| Định dạng | XML hoặc sitemap index | Plain text |
| Dùng để | Hỗ trợ Google phát hiện URL | Cho phép hoặc chặn bot crawl |
| Có đảm bảo index không? | Không | Không |
Không nên đưa vào sitemap những URL đang bị robots.txt chặn crawl.
Nếu sitemap giới thiệu một URL, nhưng robots.txt lại chặn bot crawl URL đó, website đang gửi tín hiệu không nhất quán.
Anh em có thể đọc thêm bài Sitemap là gì để hiểu cách giữ sitemap sạch.
Robots.txt khác gì 301 Redirect?
301 Redirect dùng để chuyển URL cũ sang URL mới.
Robots.txt dùng để quản lý crawl.
Nếu một URL cũ đã có URL mới thay thế, không nên chặn URL cũ bằng robots.txt. Cách tốt hơn thường là 301 Redirect từ URL cũ sang URL mới.
Ví dụ:
/bai-cu/đã gộp vào/bai-moi/
Nên dùng:
/bai-cu/ → 301 → /bai-moi/Không nên chỉ chặn:
Disallow: /bai-cu/Vì chặn crawl không giúp người dùng đi đến bài mới và cũng không truyền tín hiệu rõ như redirect.
Khi nào nên chặn bằng robots.txt?
Khi muốn hạn chế bot crawl khu vực quản trị
Với WordPress, thường có thể chặn:
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Đây là cấu hình phổ biến.
Khi website có search nội bộ tạo quá nhiều URL
Trang search nội bộ có thể tạo ra vô số URL dạng:
/?s=keyword
/search?q=keyword
/tim-kiem?keyword=abc
Nhóm này thường không có giá trị SEO riêng và có thể gây phình URL.
Tùy cấu trúc website, có thể cân nhắc noindex hoặc robots.txt. Nếu mục tiêu là không cho index, cần dùng noindex đúng cách. Nếu mục tiêu là giảm crawl vào khu vực search nội bộ lớn, robots.txt có thể được cân nhắc.
Khi có URL parameter hoặc filter không cần crawl ở quy mô lớn
Với ecommerce, khách sạn, bất động sản hoặc listing, filter có thể tạo hàng nghìn, thậm chí hàng triệu URL.
Ví dụ:
?sort=price_asc
?view=grid
?color=black&size=42&rating=5
Nếu Googlebot bị hút vào những URL này quá nhiều, crawl budget có thể bị dùng kém hiệu quả.
Tuy nhiên, không nên chặn toàn bộ filter ngay lập tức. Cần phân loại:
- Filter nào có search demand và nên index.
- Filter nào chỉ phục vụ UX.
- Filter nào nên canonical.
- Filter nào nên noindex.
- Filter nào nên chặn crawl bằng robots.txt.
Robots.txt trong faceted navigation cần chiến lược, không làm theo cảm tính.
Khi muốn ngăn bot crawl một số tài nguyên không cần thiết
Một số tài nguyên hoặc khu vực kỹ thuật có thể không cần bot crawl.
Nhưng cần rất cẩn thận với CSS, JS, ảnh và tài nguyên cần để render trang.
Không nên chặn toàn bộ:
Disallow: /wp-content/
Disallow: /wp-includes/
Disallow: /assets/
Disallow: /js/
Disallow: /css/
nếu các tài nguyên trong đó cần thiết để Google hiểu bố cục và nội dung trang.
Khi nào không nên chặn bằng robots.txt?
Không chặn thư mục chứa bài viết cần SEO
Không nên chặn:
Disallow: /blog/
Disallow: /post/
Disallow: /kien-thuc-seo/
Disallow: /dich-vu/
nếu các khu vực này chứa nội dung cần Google crawl và index.
Không chặn trang đang cần noindex
Nếu muốn Google thấy thẻ noindex, không nên chặn trang đó bằng robots.txt.
Hãy để Googlebot crawl trang, đọc noindex, sau đó Google có thể loại trang khỏi Search.
Không chặn URL cũ cần redirect
Nếu URL cũ cần 301 sang URL mới, không nên chặn URL cũ bằng robots.txt.
Googlebot cần crawl URL cũ để thấy redirect.
Không dùng robots.txt để bảo mật dữ liệu
Robots.txt là file công khai. Ai cũng có thể truy cập:
https://example.com/robots.txtNếu có dữ liệu nhạy cảm, đừng nghĩ chặn trong robots.txt là đủ.
Cần dùng xác thực, phân quyền, mật khẩu, chặn truy cập ở server hoặc các cơ chế bảo mật phù hợp.
Không chặn CSS và JS cần thiết
Google cần render trang để hiểu nội dung và trải nghiệm. Nếu chặn các file CSS, JS quan trọng, Google có thể không nhìn thấy trang giống người dùng.
Trừ khi biết rõ mình đang làm gì, không nên chặn bừa tài nguyên giao diện.
Các mẫu robots.txt thường gặp
Mẫu cơ bản cho WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Mẫu chặn search nội bộ dạng query
User-agent: *
Disallow: /?s=
Disallow: /search/

Sitemap: https://example.com/sitemap_index.xml
Lưu ý: trước khi chặn, cần kiểm tra website đang dùng cấu trúc search nào và search page có đang bị index không.
Mẫu chặn một số parameter
User-agent: *
Disallow: /*?sort=
Disallow: /*?view=

Sitemap: https://example.com/sitemap_index.xml
Không nên copy mẫu này máy móc. Với website lớn, cần kiểm tra filter nào có giá trị SEO trước khi chặn.
Mẫu nguy hiểm cần tránh trên site live
User-agent: *
Disallow: /
Cấu hình này chặn bot crawl toàn bộ website.
Nó có thể phù hợp với môi trường staging hoặc website chưa muốn public, nhưng không nên xuất hiện trên site chính đang làm SEO.
Cách kiểm tra robots.txt
Mở trực tiếp trên trình duyệt
Cách đơn giản nhất là mở:
https://domain.com/robots.txtKiểm tra xem file có tồn tại không, có trả đúng nội dung plain text không, có bị lỗi 404, 403, 500 không.
Kiểm tra trong Google Search Console
Google Search Console có thể giúp kiểm tra URL có bị robots.txt chặn không trong URL Inspection.
Khi một URL quan trọng không index hoặc không crawl, nên kiểm tra nó có bị robots.txt block không.
Dùng công cụ crawl website
Các công cụ như Screaming Frog hoặc Sitebulb có thể cho biết URL nào bị robots.txt chặn.
Khi audit, nên lọc:
- URL quan trọng bị robots.txt block.
- CSS/JS bị block.
- URL trong sitemap nhưng bị robots.txt block.
- URL redirect bị block.
- URL cần noindex nhưng lại bị block.
Kiểm tra sau khi deploy hoặc đổi theme
Mỗi lần đổi theme, đổi plugin SEO, đổi server, migrate hoặc deploy từ staging sang live, nên kiểm tra robots.txt ngay.
Lỗi rất hay gặp là môi trường staging có:
User-agent: *
Disallow: /
Sau đó deploy lên live nhưng quên gỡ.
Đây là lỗi nhỏ nhưng hậu quả rất đau.
Robots.txt và crawl budget
Với website nhỏ, crawl budget thường chưa phải vấn đề quá lớn.
Nhưng với website lớn, robots.txt có thể giúp bot tránh một số khu vực không cần crawl, từ đó giảm việc bot tiêu tốn request vào URL kém giá trị.
Ví dụ Googlebot đang crawl quá nhiều:
- URL sort.
- URL filter tổ hợp sâu.
- Trang search nội bộ.
- URL parameter tracking.
- Phân trang rất sâu không có giá trị.
Khi đó, robots.txt có thể là một phần trong giải pháp.
Nhưng cần nhấn mạnh: robots.txt không phải bước đầu tiên cho mọi vấn đề crawl budget.
Trước khi chặn, hãy kiểm tra:
- Nhóm URL đó có traffic không?
- Có impressions không?
- Có backlink không?
- Có internal link mạnh không?
- Có URL nào trong nhóm có search demand không?
- Có nên canonical hoặc noindex thay vì chặn crawl không?
Robots.txt đúng giúp crawl gọn hơn. Robots.txt sai có thể chặn nhầm cơ hội SEO.
Robots.txt và index bloat
Index bloat là tình trạng quá nhiều URL kém giá trị được Google index.
Robots.txt có thể liên quan đến index bloat, nhưng không phải lúc nào cũng là công cụ xử lý chính.
Nếu một URL đã bị index, rồi anh em chặn robots.txt, Googlebot có thể không crawl được trang để thấy noindex hoặc thay đổi nội dung. Trong một số trường hợp, URL vẫn còn xuất hiện trên Search vì Google biết URL qua nguồn khác.
Vì vậy, với URL đã index mà muốn loại khỏi Search, noindex thường rõ hơn robots.txt.
Robots.txt phù hợp hơn khi muốn ngăn Googlebot crawl một khu vực không cần thiết ở quy mô lớn, sau khi đã phân loại và xử lý index đúng cách.
Đây là lý do khi xử lý index bloat, cần kết hợp robots.txt với noindex, canonical, sitemap, redirect và content pruning.
Robots.txt và sitemap
Nên khai báo sitemap trong robots.txt.
Sitemap: https://example.com/sitemap_index.xmlNhưng sitemap và robots.txt phải nhất quán.
Không nên có tình huống:
- Sitemap chứa URL A.
- Robots.txt lại chặn URL A.
Nếu muốn Google crawl và index URL đó, đừng chặn nó trong robots.txt.
Nếu không muốn Google crawl URL đó, cũng không nên đưa nó vào sitemap.
Một sitemap sạch và robots.txt sạch sẽ giúp Google hiểu website rõ hơn.
Robots.txt và log file SEO
Log file SEO cho biết Googlebot thật sự crawl những URL nào.
Khi kết hợp log file với robots.txt, anh em có thể kiểm tra:
- Googlebot có đang crawl nhiều URL không cần thiết không?
- Robots.txt đã chặn đúng khu vực chưa?
- Có URL quan trọng nào bị chặn nhầm không?
- Googlebot có gặp nhiều 403, 404 hoặc redirect do rule sai không?
- Sau khi sửa robots.txt, hành vi crawl có thay đổi không?
Với website lớn, không nên chỉnh robots.txt chỉ bằng cảm giác. Hãy dùng dữ liệu từ log file, crawl tool và GSC để quyết định.
Robots.txt trong WordPress
WordPress có thể tạo robots.txt ảo nếu website chưa có file robots.txt vật lý.
Nhiều plugin SEO như Rank Math, Yoast SEO cũng cho phép chỉnh robots.txt trong dashboard.
Khi dùng WordPress, cần lưu ý:
- Kiểm tra website đang dùng robots.txt ảo hay file thật trên server.
- Không để nhiều plugin cùng can thiệp gây xung đột.
- Không chặn toàn bộ
/wp-content/nếu trong đó có CSS, JS, ảnh cần render. - Không chặn thư mục chứa bài viết, sản phẩm, dịch vụ.
- Luôn khai báo sitemap đúng URL.
- Kiểm tra lại sau khi đổi plugin SEO hoặc đổi theme.
Mẫu cơ bản cho WordPress thường chỉ cần:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Đừng làm robots.txt phức tạp nếu website chưa thật sự cần.
Những lỗi robots.txt thường gặp
Chặn toàn bộ website
User-agent: *
Disallow: /
Đây là lỗi nghiêm trọng nếu xuất hiện trên site live.
Nó thường xảy ra khi deploy từ staging sang live mà quên đổi robots.txt.
Chặn nhầm thư mục nội dung
Ví dụ:
Disallow: /blog/
Disallow: /dich-vu/
Disallow: /product/
Nếu các thư mục này chứa URL cần SEO, chặn như vậy có thể làm Googlebot không crawl được nội dung quan trọng.
Chặn CSS và JS quan trọng
Google cần truy cập tài nguyên để render trang. Chặn CSS, JS quan trọng có thể khiến Google hiểu trang không đầy đủ.
Vừa noindex vừa Disallow
Nếu trang bị Disallow, Googlebot có thể không thấy noindex.
Nếu mục tiêu là chặn index, đừng chặn crawl trước khi Google xử lý noindex.
Sitemap sai hoặc không khai báo sitemap
Không khai báo sitemap trong robots.txt không phải lỗi chết người, nhưng khai báo đúng giúp bot tìm sitemap dễ hơn.
Lỗi đáng ngại hơn là khai báo sitemap sai URL, sitemap 404 hoặc sitemap chứa URL không sạch.
Chặn URL redirect cần Googlebot thấy
Nếu URL cũ đã 301 sang URL mới, Googlebot cần crawl URL cũ để thấy redirect.
Không nên chặn URL cũ bằng robots.txt nếu mục tiêu là chuyển tín hiệu sang URL mới.
Dùng robots.txt để bảo mật
Robots.txt là file công khai.
Nếu có khu vực nhạy cảm, phải bảo vệ bằng đăng nhập, phân quyền hoặc cấu hình server, không phải chỉ Disallow.
Copy robots.txt từ website khác
Robots.txt phụ thuộc vào cấu trúc từng website.
Copy mẫu từ website khác có thể chặn nhầm thư mục quan trọng hoặc không chặn đúng khu vực cần thiết.
Checklist audit robots.txt
Kiểm tra file robots.txt
- File có tồn tại ở root domain không?
- File có mở được bằng trình duyệt không?
- File trả status code 200 không?
- File có đúng định dạng plain text không?
- File có bị cache sai không?
- File có khai báo sitemap đúng không?
Kiểm tra rule chặn crawl
- Có
Disallow: /trên site live không? - Có chặn thư mục bài viết không?
- Có chặn trang dịch vụ không?
- Có chặn sản phẩm hoặc danh mục chính không?
- Có chặn CSS, JS, ảnh cần render không?
- Có chặn URL cần Google thấy redirect không?
Kiểm tra quan hệ với sitemap
- URL trong sitemap có bị robots.txt chặn không?
- Sitemap khai báo trong robots.txt có đúng không?
- Sitemap có chứa URL noindex, redirect, 404 không?
- Sitemap có chứa URL bị Disallow không?
Kiểm tra quan hệ với noindex
- Có trang noindex nào đang bị Disallow không?
- Google có crawl được trang để thấy noindex không?
- Trang cần chặn index có đang dùng noindex đúng cách không?
Kiểm tra sau thay đổi lớn
- Sau migration.
- Sau đổi domain.
- Sau đổi HTTP sang HTTPS.
- Sau đổi theme.
- Sau đổi plugin SEO.
- Sau content pruning.
- Sau chặn filter hoặc parameter.
Bảng quyết định nhanh: robots.txt, noindex, canonical hay redirect?
| Tình huống | Hướng xử lý thường phù hợp |
|---|---|
| Muốn bot không crawl khu vực kỹ thuật không cần thiết | Robots.txt |
| Trang cần tồn tại nhưng không cần xuất hiện trên Google | Noindex |
| URL phụ gần giống URL chính nhưng vẫn cần truy cập | Canonical |
| URL cũ không còn tồn tại, có URL mới liên quan | 301 Redirect |
| Trang search nội bộ tạo quá nhiều URL | Noindex hoặc robots.txt tùy mục tiêu crawl/index |
| URL filter có search demand riêng | Có thể index và self-canonical như landing page |
| URL filter không có demand và tạo crawl waste lớn | Cân nhắc canonical, noindex hoặc robots.txt sau khi phân loại |
| Trang nhạy cảm cần bảo mật | Không dùng robots.txt, cần bảo vệ bằng xác thực hoặc server |
Ví dụ robots.txt cho blog SEO
Với một blog SEO như maikimtuyen.com, mục tiêu là để Google crawl các bài viết, trang dịch vụ, chuyên mục quan trọng và các cụm nội dung chính.
Cấu hình robots.txt không nên quá phức tạp.
Có thể ưu tiên:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://maikimtuyen.com/sitemap_index.xml
Sau đó kiểm tra thêm:
- Trang search nội bộ có bị index không?
- Tag có bị phình quá nhiều không?
- Attachment page có bị index không?
- Có URL parameter nào bị Google crawl nhiều không?
- Sitemap có sạch không?
Không nên chặn vội category, tag hoặc thư mục blog nếu chưa phân tích dữ liệu.
Ví dụ robots.txt cho ecommerce
Ecommerce thường phức tạp hơn blog vì có nhiều filter, sort, search page và parameter.
Cần audit trước khi chặn.
Nhóm có thể cân nhắc kiểm soát:
- Search nội bộ.
- URL sort.
- URL view.
- Parameter tracking.
- Tổ hợp filter quá sâu.
- Cart, checkout, account.
Nhưng cần giữ crawl cho:
- Trang danh mục chính.
- Trang sản phẩm quan trọng.
- Landing page filter có search demand.
- Trang thương hiệu có nội dung riêng.
- Bài blog hỗ trợ mua hàng.
Với ecommerce, robots.txt sai có thể làm mất cả một nhóm landing page có giá trị. Vì vậy cần làm cùng crawl data, GSC và log file.
Ví dụ robots.txt cho website dịch vụ
Website dịch vụ thường ít URL hơn ecommerce, nên robots.txt nên đơn giản.
Không nên chặn:
- Trang dịch vụ.
- Trang dịch vụ con.
- Trang local có giá trị.
- Bài blog hỗ trợ chuyển đổi.
- Case study.
Có thể cân nhắc noindex hoặc chặn crawl tùy mục tiêu với:
- Landing page test.
- Trang thank you.
- Trang search nội bộ.
- Trang campaign ngắn hạn không cần organic.
Nhưng với trang cần chặn index, noindex thường rõ hơn robots.txt.
Robots.txt trong quy trình technical SEO
Robots.txt nên được kiểm tra trong các bước technical SEO sau:
- Khi audit website ban đầu.
- Khi website không index hoặc index chậm.
- Khi GSC báo URL bị robots.txt block.
- Khi migration website.
- Khi đổi theme hoặc plugin SEO.
- Khi xử lý faceted navigation.
- Khi audit crawl budget.
- Khi kiểm tra index bloat.
- Khi dọn sitemap.
- Khi làm content pruning quy mô lớn.
Robots.txt không phải file chỉnh một lần rồi quên. Mỗi lần cấu trúc website thay đổi, file này cần được kiểm tra lại.
Kết luận
Robots.txt là file dùng để hướng dẫn bot công cụ tìm kiếm khu vực nào trên website được phép hoặc không được phép crawl. Đây là một phần nhỏ trong technical SEO, nhưng ảnh hưởng rất lớn nếu cấu hình sai.
Điều quan trọng nhất là phải hiểu đúng vai trò của robots.txt.
Robots.txt dùng để quản lý crawl, không phải công cụ chặn index tuyệt đối.
Nếu muốn chặn một trang khỏi Google Search, hãy nghĩ đến noindex.
Nếu muốn xử lý URL trùng hoặc gần trùng, hãy nghĩ đến canonical.
Nếu URL cũ đã có URL mới thay thế, hãy nghĩ đến 301 Redirect.
Nếu muốn giới thiệu URL quan trọng cho Google, hãy dùng sitemap sạch.
Đừng hỏi đơn giản:
Website đã có robots.txt chưa?
Hãy hỏi sâu hơn:
Robots.txt hiện tại có đang giúp Googlebot crawl đúng khu vực cần ưu tiên, hay đang vô tình chặn nhầm những URL quan trọng?
Chỉ cần trả lời được câu hỏi đó, anh em sẽ dùng robots.txt tỉnh táo hơn rất nhiều.
Để hiểu sâu hơn, anh em có thể đọc tiếp:
- Noindex là gì? Khi nào nên chặn Google index một trang?
- Sitemap là gì? Cách tối ưu sitemap để Google crawl đúng URL
- Canonical URL là gì? Cách xử lý URL trùng lặp đúng SEO
- Crawl budget là gì? Cách tránh lãng phí crawl budget trên website lớn
Nếu anh em muốn học SEO bài bản hơn từ nền tảng, có thể tham gia nhóm SEO từ số 0 để cùng trao đổi thêm các case thực chiến.
Cần trao đổi riêng về SEO website, anh em có thể liên hệ mình qua Zalo 0369 608 268.

Cám ơn bạn đã đọc trọn vẹn bài viết này, đừng quên đăng ký để nhận thông tin và nội dung mới nhất từ Tuyến nhé!
➡ Tham gia Nhóm SEO từ số 0 Chia sẻ kinh nghiệm, thực hành từng bước – không lý thuyết suông. Học chậm, chắc, và cùng nhau tiến bộ mỗi ngày.
Tham khảo thêm
15 Công Cụ Tải Video Từ YouTube, TikTok, Facebook, X Và Nhiều Nền Tảng
Bạn cần tải lại video đã đăng, lưu tư liệu được chủ sở hữu cho phép hoặc lấy file để dựng nội dung cho khách hàng? Thay vì thử nhiều website...
Cách Tạo Ảnh Quảng Cáo Bằng ChatGPT: Quy Trình Và Prompt Mẫu
Bạn có thể dùng ChatGPT để tạo key visual, ảnh sản phẩm có bối cảnh, poster, ảnh social, storyboard carousel hoặc bản nháp billboard. Tuy nhiên, kết quả có dùng được...
23 Sách Nguyễn Duy Cần PDF: Danh Mục Và Link Đọc
Nếu từng đọc Tôi Tự Học, Óc Sáng Suốt hoặc Thuật Tư Tưởng, bạn có thể đã quen với cách viết điềm tĩnh, giàu suy ngẫm của học giả Thu Giang...
Bộ Tài Liệu SGK PDF Lớp 1–12 Năm Học 2026–2027
Phụ huynh, học sinh và giáo viên có thể tham khảo bộ tài liệu SGK PDF dành cho 12 khối lớp trong bài viết này. Mỗi lớp được đóng thành một...
Breadcrumb Schema trên WordPress: cấu hình đúng với Rank Math
Breadcrumb ở đầu bài viết cho người đọc biết họ đang ở đâu và có thể quay lại chủ đề lớn hơn bằng đường nào. Trong mã nguồn, BreadcrumbList giúp công...
Google đã gỡ FAQ rich results từ 7/5/2026: còn nên giữ FAQ Schema không?
Từ ngày 7/5/2026, FAQ rich results không còn xuất hiện trên Google Search. Điều đó có nghĩa những câu hỏi và câu trả lời dạng mở rộng dưới kết quả tìm...